


互联网是有记忆的。但从物理意义上来说,这种“记忆”,也许比你想象的要脆弱。
今年3月,新浪云服务团队发布公告称,新浪云服务将于2026年9月16日24时起正式下线,并永久终止服务。
一场跨越国界,由民间发起的数据抢救计划由此开始。新浪云服务器相关联的近700TB的庞大数据,被分成量级更小的数据包,随机交给志愿者们进行存档。1TB等于1024GB,换算成文字,700TB约等于30亿本10万字的中篇小说。
有人说,这可能是迄今为止“最大的互联网抢救行动”,并将其命名为“新浪云补全计划”。参与者们为此感到振奋,觉得“这是一种我为人人,人人为我的使命”。
而支撑“新浪云补全计划”开展的背后,是将“互联网数据存档”作为一项事业的民间组织与机构。他们寻找那些早期的、即将关停的,或者看上去岌岌可危的网站、软件,并将其保存下来。
有网友将这群“互联网数据存档”志愿者称之为——“赛博(数字虚拟世界)史官”。这样做究竟有什么意义?有参与者告诉新京报记者,他其实也不知道。毕竟谁也无法判断,如今保存下来看似毫无意义的数据,在未来意味着什么。
但有参与者告诉新京报记者,宏大地说,这关乎“集体记忆”与“历史”,就像从古墓里发掘出的一件前人物品,却能用于揭示人类物质文明与技术演进。
从一纸停服公告开始
3月初,新浪云发布停服通知时,并没有引起特别大的波澜——毕竟这是一个早已淡出主流市场的平台。
2009年,风头正盛的门户网站新浪公司推出了云计算产品Sina App Engine(SAE),也就是新浪云平台。新浪称,这是国内首个平台即服务的公有云计算平台——即由平台提供开发与运行环境,用户不再需要关心底层硬件,只需专注于应用开发。当时,极低的价格吸引了许多普通人和小型开发者,人们通过新浪云服务器托管了近千万的小型应用、博客与个人网站。
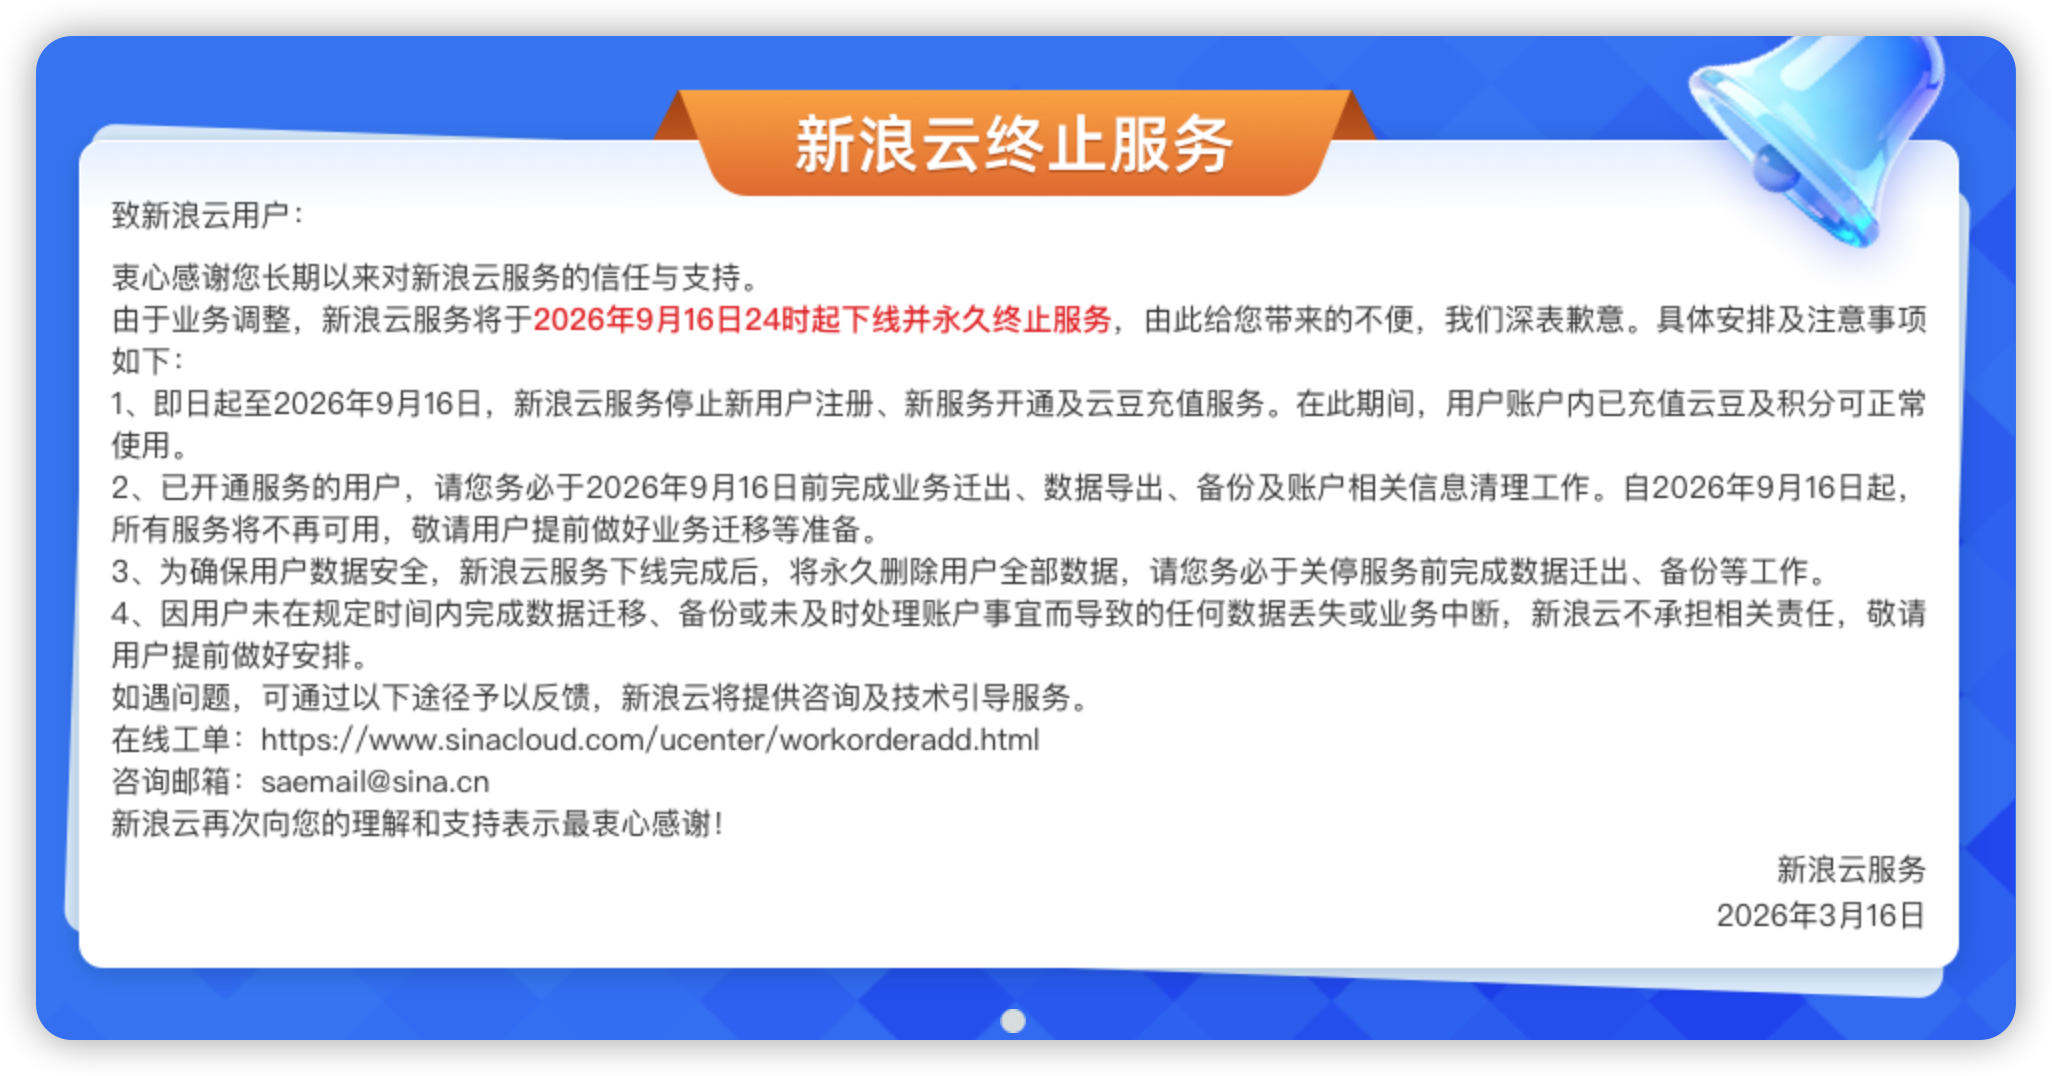
新浪云终止服务的公告。 官网截图
起初,刘小桥也没有意识到新浪云关停究竟意味着什么。从事计算机相关工作的他,是一位互联网历史数据存档爱好者。2021年,刚刚上大学的他成立了一个名为save the web project(互联网保存项目)的民间组织。成员们做的事和组织的名字一样,他们游荡于旧世界里即将消失的网页,并保存下来。
直到小组里一位年纪更大的朋友提醒,这可能会涉及不少早期视频等互联网历史资料。
新浪视频、B站等平台的早期内容,曾存储在新浪云服务器上。此后,尽管B站将原先存放在第三方服务器上的数据迁移到自己的服务器上,但随着时间推移,许多视频因各种原因已无法在站内访问。对仍想找回这些早期内容的网友来说,新浪云服务器便成了寻找原始视频的重要去处。
这意味着,一旦关停,与新浪云相关联的数据就有可能丢失,再也无法登录找回。因为许多小组成员都是B站用户,大家决定优先保存B站上与新浪云关联的早期视频。
6月份,刘小桥断断续续地开始写代码,直到8月初才完成。与B站相关的数据大概有28.9TB,约十多万条,如果全部由刘小桥一人下载,工作量极大。于是,刘小桥将项目发布到了社交编程平台GitHub,通过分包的方式,在十二天内完成了这批视频的保存。
而在刘小桥不知道的地方,8月的一个晚上,另一个名为“失传媒体”的爱好群组,也关注到了新浪云关停的消息。
“失传媒体”小组内大多是广播电视爱好者。一些人因为找不到早年的电视节目而到小组求助,渐渐聚集起了一批人。群组内有三百多人,大家时常互相帮助,常有人发,“我小时候看过这个视频,但是找不到了,不知道有人有印象吗?”
早期,许多人还习惯在新浪视频、土豆网、优酷等视频网站上传自己录制的电视节目。而一些官方网站因为网址迁移、无力运维等原因,相关视频网页早已失效。也因此,新浪视频等地成了小组成员们“考古”的重要来源。
得知这个消息的当晚,其中一位小组成员林霎开始彻夜查找解决方法。当时,他根据新浪视频的编码估算,视频总量可能有两千万条。以小组内能够动员的人力和带宽,就算连轴转,林霎估计,可能也不足以在期限到来前存档10%。
搜索资料时,林霎偶然了解到了一个名为Archive Team(存档团队)的国际志愿者组织。这个组织由美国档案工作者杰森·斯科特(Jason Scott)于2009年创立,在抢救和保存那些面临消失风险的网络内容上,有丰富的经验。
林霎不抱希望地给Archive Team发了一封邮件寻求技术支持,没想到,几天后,他得到了回复。
“This is indeed something we need to do something with(我们的确需要为此做一些什么)”,对方回复。Archive Team告诉林霎,不同于文字,视频文件体量极其庞大,这意味着需要做出取舍,比如限定存档视频范围,或是降低存档画质。又过了几天,林霎再次收到回复,Archive Team团队已经写好了相关代码,并已经公布任务到官网上,愿意参与者即刻可以开始加入存档。
Archive Team使用的是一种众包方式来进行归档。为了降低参与门槛,团队开发了一套名为warrior(战士)的虚拟机环境。“就跟战场指挥官给你下了个命令,然后我们都去干,干完回来就完事了。”一位志愿者类比道。
根据Archive Team的测算,共有两亿条左右的视频需要保存。
全球志愿者的协作
Archive Team有另一套系统,专门用于负责追踪、并公开下载任务。页面如同一份普通的排行榜,从高到低,可以看到不同用户对应完成的任务数、下载量,有些数字还在持续增长着。参与者唯一透露出来的信息,只是一串英文ID,谁也不知道对方是谁、身处何处,过着怎么样的生活。而这些素未谋面的人,就这样通过网络的另一端产生了联系,共同保存一些可能将要消失的东西。
除了存档原始视频,九月初,志愿者们还发起了一项新项目:存档视频元数据,包括视频的发布日期、发布者当时撰写的文案,甚至评论、弹幕等内容。
一位志愿者向新京报记者解释,存档元数据看似增加了工作量,实际上却不可或缺。许多早期视频画质极低,甚至难以辨认其中的声音内容。只有结合当时的视频描述等信息,才能在需要时还原视频发布的背景,理解其原本的含义,“否则,意义会大大缩减。”
一个月内,陆续有上千名志愿者加入这场数据抢救行动,其中不乏外国志愿者。到9月14日,新浪视频相关数据已保存约560TB。此时,距离新浪云服务器正式关停,已不足三天。志愿者宋果心急如焚,决定将新浪视频的存档进展发布到社交媒体上。
距离新浪云服务器关停还有54小时15分钟时,宋果为这场行动取名“新浪云补全计划”,并将其称为“2026年互联网最大抢救性保存……是一场与时间赛跑的庞大工程”。这番话激发了更多网友参与的热情。此前,这场数据抢救行动主要活跃于数据存档爱好者的圈子里。随着消息在社交媒体上传播,新浪视频存档才真正进入公众视野,相关话题登上热搜。接下来的两天里,又有数百人加入。
关注度的骤然上升,也带来了意想不到的混乱。短时间内激增的访问量可能触发了新浪云的保护机制,一些志愿者发现,原本能够正常访问的视频接口和元数据也开始无法获取。原本出于好意的宣传,反而引发了志愿者之间的相互指责与争吵。
但留给他们的时间已经不多。随着部分视频下载接口陆续关闭,宋果发现,数据保存的速度开始大幅下降。这几天,他几乎时刻守在电脑前,实时记录着存档进度:“距离关停的第47小时04分钟,有超过1813位志愿者共同上传保存了大约637TB数据。
9月15日,从早上四点开始,数据量急转直下,大量的显示任务结束或报错,怀疑新浪一部分服务器已经死了。
9月16日,距离关停的第14小时57分,已完成649.28TB,又有8位志愿者加入存档行动。”
在最后的两个小时,距离完成任务还差5%,一位只有15岁、来自北京的初三学生开了十台服务器,也加入了这场存档行动,“能救一点是一点。”他是新京报记者采访中年龄最小的参与者。
随着关停时间逼近,视频频繁报错、获取失败的情况越来越严重。但仍有一些志愿者不愿放弃,继续“在废墟中扒拉”,试图从中找到还有可能救回的数据,尽管希望已经十分渺茫。
这场浩浩荡荡、被称为“2026年最大的数据抢救行动”的计划,就这样暂告一段落。Archive Team的追踪系统显示,共有2138人参与其中,成功抢救了659.61TB的数据。但仍有约800万条视频未能及时保存,永远失去了被找回的机会。
“真是全球志愿者协作的奇迹。”林霎感叹。
“数字衰退”
事实上,在这场数据拯救行动中,占据多数的不是亲历互联网黄金时代的80、90后,而是00后们。如同天涯社区关停时人们的不舍,新浪云服务器的关停,也代表了这些00后年轻人们一部分童年的消失。
志愿者们的回忆也各不相同。对于有的人来说,新浪云服务器托管了自己的第一个小网站、小游戏,有人记得的是一段早期动画鬼畜视频。在新浪云数据抢救行动中,存档量排名第三的是一位2003年出生的男生。在他看来那是一个更纯粹的内容时代,没有沾染上AI味,很多内容全靠创作者“手搓”,真诚又独特。
志愿者梁谷是一位大二学生。小时候,每天吃完晚饭,他就搬着小板凳坐在电视机前,他喜欢看《东方时空》《新闻调查》,还有各式各样的公益广告。年幼的他,懵懵懂懂,很多内容看不太懂,却觉得在无形中建立了他的“三观”。
11岁时,梁谷学会了上网。幸运时,一些连官方都没有保存的电视节目,梁谷却能够顺着关键词,在土豆网、新浪视频上找到想要的早期视频内容。
但互联网技术不断迭代,许多东西也随之改变。过去主流的 Flash 播放器如今已不再适配,互联网协议也发生了变化,梁谷需要借助技术手段,才能让那些早期视频重新播放。
有时,梁谷翻遍整个互联网,什么都找不到。最为痛苦的,是好不容易找到相关的网页,点开时,却显示已经无法访问,“特别是2009年以前的内容。”
得知新浪云服务器关停的消息后,梁谷开始有意识的把新浪视频上的东西下载下来,每天花五六个小时,存了共七张硬盘。梁谷也会把印象深刻的新浪视频发在网上。有一期是关于电视剧《红楼梦》中林黛玉扮演者陈晓旭的早期采访视频,画质连360P都不到,却引来很多人对于陈晓旭的怀念。
“以前很多消失的互联网资源,我们没能留存。现在我们必须得好好地存下来。”梁谷说。
美国科幻作家苏珊·多诺万在她出版的小说《纽约市地理学》中,曾描述过这样一个未来世界:2250年,由于电磁干扰,大量数据被删除。
“我当时在想,如果人们经历一场所有数字信息都消失的事件,这会给他们带来怎样的改变?”苏珊·多诺万说。
这个故事里,灾难没有毁灭世界,却彻底改变了人们存储信息的方式,人们变得不再依赖虚拟世界,印刷制品重新复苏。而失去了习以为常的照片、社交媒体内容,历史学家们不得不重新回到城市的废墟里,寻找21世纪初的记忆。
虽然这是一种极端的想象,但在人类每日产生海量数据的同时,一些数据正在不知不觉中消失,确是事实。2023年,美国皮尤研究中心(Pew Research Center)曾做过一项研究,他们随机抽取了100万个网页,发现在2013年的网页里,38%在2023年已无法访问。而即使是2021年的页面,仅仅两年后,也有大约五分之一的页面无法访问。研究者们将这一现象称为“数字衰退”。
南京大学信息管理学院副教授赵宇翔长期关注互联网数字记忆的存储与保存。他告诉新京报记者,我们日常接触到的网络数据,大多存储在服务器中,其长期留存离不开持续的资金投入与技术维护。除了发布者主动删除,数据能否继续存在,很大程度上也取决于平台的决策。尤其是互联网早期的许多平台,在市场竞争中逐渐退出后,相关数据往往因缺乏后续管理、技术支持中断等原因,最终走向消失。
2014年,56网被收购,许多用户上传的视频不再能访问;2018年,运营12年的网易博客停止服务,标志着博客时代的落寞。除此之外,国内第一家Blog托管服务商博客大巴(blogbus)、百度空间、微软MSN Spaces、51博客等多款昔日爆红的主流博客平台,也已经停止运营;2019年,因业务收缩,中国早期网络相册服务的代表网易相册停止运营;2024年,随着移动互联网的兴起,用户流失,人人网停止服务……
而在中文互联网史上,因关停引发最多关注的,可能是曾经影响整整一代人的天涯社区。
成立于1999年的天涯社区,被誉为“全球华人网上家园”。2004年,在全中国网民数量只有7950万时,天涯社区的日访问量就已经达到2000万。2005年,天涯社区在全球中文社区类网站中排名第一。一个天涯的帖子,就是一个著名的网络小说或事件,电影《滚蛋吧!肿瘤君》《夏洛特烦恼》也都改编自天涯热帖。
关停的原因有些许荒谬。2023年,天涯公司因为拖欠海南电信机房服务管理费300万元,被停止访问,引发互联网震动。这代表了无数中国网民重要人生资料的消失。许多人错愕、悲伤又愤怒,想尽办法,希望能够找回以前的帖子。
天涯的用户是幸运的。2026年6月1日,天涯社区筹集了资金,重新复活。尘封的账号与内容,也都没有丢失。
但除此之外,大部分平台关停后,如果用户没能及时保存,所有账号数据及其中内容、日志、照片等信息将被全部清空。
网站、服务器的关停,一方面是市场竞争、技术迭代下的常态,也是互联网快速发展的一个缩影。但另一方面,这也使得用户始终“流浪”于不同的平台,似乎没有一个平台能够真正的“从一而终”。
Archive Team 创始人杰森·斯科特曾说,他们的成立源于愤怒和无力感,“我们感觉自己被公司左右,任由他们决定哪些东西会生存,哪些东西会消亡。”许多参与新浪云抢救的志愿者,也都与新京报记者谈到相似的感受。
前述那位读初三的志愿者,几年前,曾在某一平台存下了自己费劲敲下的代码,而平台猝不及防的关停,让他没能来得及备份。这是他第一次意识到互联网的记忆是脆弱的。他开始“对网络世界缺乏安全感”,所有的数据,都会用硬盘拷贝两份,以防悲剧再次发生。
给互联网修一座档案馆
为了应对互联网数据不可控的消逝,需要有人持续地留意、记录和保存。这或许是个笨办法,却也是目前为数不多、甚至不可替代的办法。
互联网档案馆(Internet Archive)是全世界最早实施互联网数字信息存档的非营利组织。在他们位于美国加利福尼亚州的总部里,矗立着一座嗡嗡作响的黑色服务器塔。作为一个展示品,服务器内储存着8350亿个网页、4400万册书籍和文本、1500万份音频录音以及其他各种资料,而这只是他们存档内容的10%。
创始人布鲁斯特·卡勒是互联网的早期架构师之一,硅谷众多巨头的历史都与他息息相关,但他毕生的梦想却是建立一个包罗万象的图书馆。1996年,布鲁斯特创业,并于同一年初步建立了互联网档案馆。三年后,他的公司被亚马逊收购,靠着收购获得的巨款,他得以继续运营这个公益组织。
通过互联网档案馆,用户可以搜索或根据分类,查看过去的网站,包括已经失效的网页快照。每当有人打开一个旧网页,那座黑色服务器塔上的小灯就会闪烁。2025年10月,互联网档案馆迎来了1万亿网页存档的里程碑。这也是目前世界范围内对互联网信息资源保存历史最久远、范围最广、内容最完善的机构。
而这次有关于新浪云存档的相关数据资料,未来也都会经由志愿者们整理,上传至互联网档案馆,供人查阅。
而在互联网档案馆成立6年后,2002年的中国互联网世界,也有人决心做这样一件类似的事。
1997年时,国内还没有搜索引擎,但网站已经遍地开花,北京大学计算机系主任李晓明教授等人带领学生,决心开发一个搜索工具,取名叫天网搜索。
搜索引擎的底层运行逻辑并不复杂。机器会按照一定的规则在互联网上抓取网页。因为网页总是在时刻更新,而为了给用户提供最新的内容,抓取到的新网页便会将旧的网页覆盖。
“其实这就是互联网的规律,以前的东西说没就没了,谁也没有办法保证它总是在那里。”李晓明想,“既然都抓取了,有点可惜,那我就把他们都存起来。”
这个工作对于李晓明团队来说并不算难,“就是顺手的事。”但因为存储价格高,李晓明当时只保存了文本,没有图片和视频。
2002年1月18日,在一个项目基金支持下,北京大学网络实验室启动了“中国Web信息博物馆”的建设,致力于有效地保存中国互联网上曾经出现过的历史信息,为大众提供中国历史网页浏览服务。网站的域名,李晓明取名为“web infomall”,由information(信息)与mall(超市)组合而来,“就是一个信息超市。”
早期的中国Web信息博物馆页面,可以查询网址下对应日期的历史信息。这个网站现已关停。 受访者供图
这个项目直到2015年停止,网站关停。背后的原因并不复杂。李晓明告诉新京报记者,只是因为移动互联网的兴起,更多信息存储在了手机App内,传统网站的内容越来越少。2016年,北京大学将项目捐赠给了中国计算机学会,后来成为了人工智能开发的重要语料库。
近20年积累下来的25亿个网页数据,总量达200TB。如今,这些数据被存储在一个宽约40厘米的黑色正方体盒子里,放在李晓明的办公室。盒子上标着几个字:中国网络历史信息十五年。李晓明向所有人开放这批数据,只要不用于商业用途。目前,已有30多个科研组织或个人拷贝了这批数据。
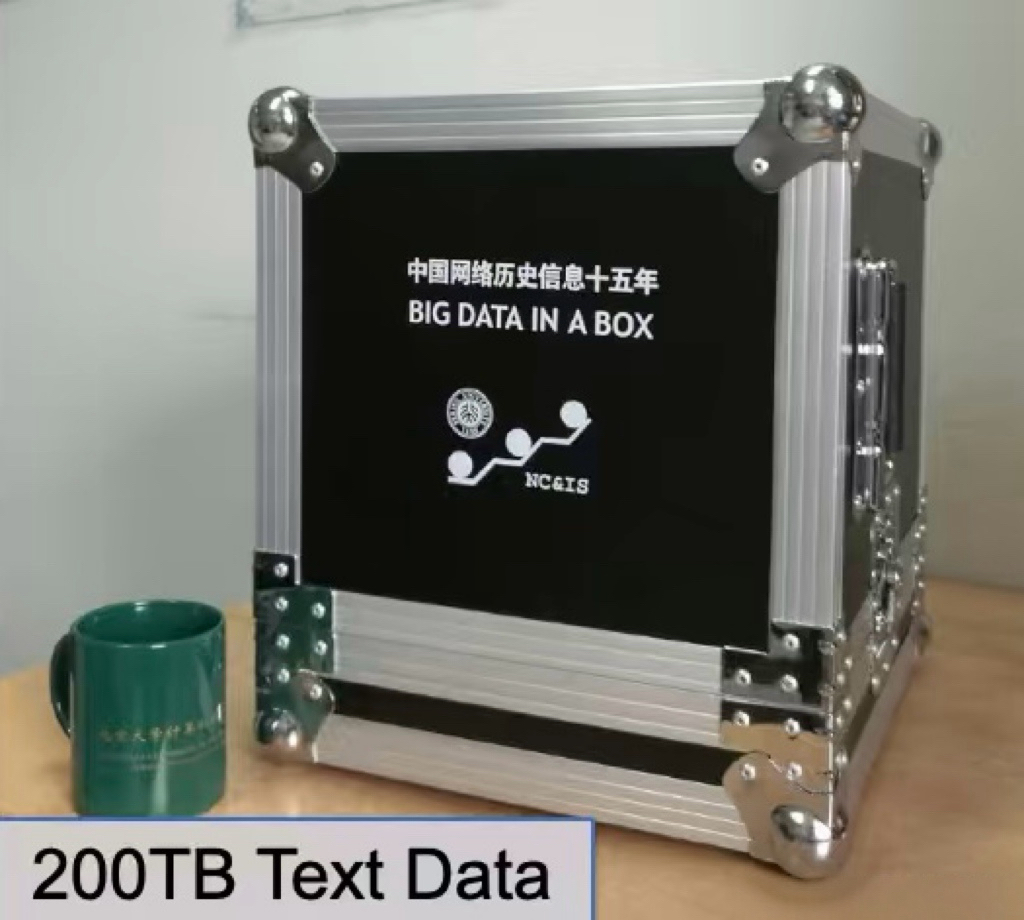
中国Web信息博物馆项目存档的200TB早期互联网历史数据,被存在这个小黑盒子里。 受访者供图
为“无人问津”的数据留底
但因为技术限制,李晓明无法保证,所有曾经存在过的网页都被完整保存下来,难免有所缺漏。
而那些没能被保存的网页,真的就这样消失了吗?
南京大学信息管理学院教授赵宇翔告诉新京报记者,事实上,中国政策与实践语境下的数据资产、数据确权等概念都是近几年才出现的。互联网发展早期,平台关停后应该如何处理数据、数据究竟属于谁、又应该由谁保存,并没有明确的规定。在赵宇翔看来,许多互联网数据的丢失是历史遗留问题,很难找到某一方为此负责。如果想要找回,某种意义上,就如同在茫茫数字汪洋中考古。
赵宇翔介绍,近些年,相关规定也在逐渐完善。一方面,平台应该承担起相应的责任,在关停前须提前告知用户,并留出足够的时间,让用户能够及时保存或迁移数据。Archive Team创始人斯科特甚至提出,在线服务关闭后的一段时间内(比如5年),用户仍应有权恢复自己的数据。在这段时间里,任何想要找回自己信息的人,都可以自行下载,或者至少自费购买一张CD拷贝,由相关公司寄送给他们。
赵宇翔对此相对乐观。在他看来,近年来,大型互联网平台的社会责任意识有所提升,“像以前那样,说没就没的情况会越来越少。”相比之下,类似的风险可能更多存在于小型互联网平台和不太成熟的应用程序上。
从制度层面来看,互联网信息资源的保存也已经逐渐进入公共文化机构的视野。2016年,《全国档案事业发展“十三五”规划纲要》明确提出,要“研究制定重要网页资源的采集和社交媒体文件的归档管理办法”。2019年,国家图书馆首个互联网信息战略保存基地落户新浪。此后,新浪网发布的新闻以及微博上公开发布的博文,也被纳入国家图书馆的收藏范围。互联网信息资源的保存问题,在最新的《公共文化服务体系建设“十五五”规划》中也有所体现。
不过,赵宇翔也强调,对于大型公共机构而言,数据保存往往带有一定的选择性,更看重其公共价值。但这并不意味着普通人随手发表的日常记录就没有留存的必要。“因为互联网发展之初最大的意义便在于,普通人也有了叙述历史的权利。”赵宇翔说。
但这也意味着,这些日常、琐碎的互联网记录,往往难以进入正式的保存体系。它们的留存,更多时候依赖民间力量的自发行动。
中国Web信息博物馆关停后,刘小桥逐渐意识到,针对普通用户的互联网内容,仍缺少持续的保存力量。经历了多次“在线数据消失的时刻”后,他决定成立save the web project。
他印象最深刻的,是一款名为“画吧”的国内App。这是一款成立于2013年的绘画软件,早年在绘画圈颇受欢迎,不少画师会在社区里分享自己的作品、相互交流。2024年,因为老板欠款、无力支撑运维,这款软件不得不关停。
关停之前,刘小桥保存了App上所有用户的作品,并将这件事发布在社交媒体上。如果画吧的用户想找回以前的作品,可以发邮件联系他。
刘小桥没有想到,画吧关停后的两年里,每个月仍能收到三四封邮件。有人收到作品后很感动,专门写来长长的邮件,说“这些作品是她的来时路”。
但除了偶尔的感动,这注定是一项孤独的工作。尽管组织里有十余人,大多数时候,刘小桥仍然是一个人写代码、独自推进项目。
这还是一份需要资金支持的事业。互联网档案馆能够持续运营二十多年,主要依靠创始人布鲁斯特·卡勒的个人积蓄和外界捐赠。刘小桥曾与卡勒有过交流,对方告诉他,1TB的数据,从保存到长期在线展示、供用户查阅,大约需要500美元,涉及服务器、网络带宽、机房场地租赁等费用。
但目前,刘小桥常常需要自掏腰包,或者依靠群组成员资助。这也导致能做的事十分有限。短期内,他还无法像李晓明、布鲁斯特·卡勒一样,让历史数据“活”起来,建立一个可供公众访问的网站。更多时候,他就像一个互联网的巡逻兵,四处搜寻那些看起来摇摇欲坠的在线平台,然后默默将数据存档进硬盘。
如今,68岁的李晓明,将更多精力投入到了教育领域。但谈起二十多年前做过的互联网博物馆,他仍然十分兴奋。得知如今又有年轻人愿意尝试做类似的事情,他表示很欣慰。
“谁也无法判断,现在你留存下来的互联网在线内容,未来到底有什么价值。”李晓明说,“但我觉得,时间越长,数量越多,意义越大。”
(应受访者要求,文中刘小桥、林霎、宋果、梁谷为化名)
新京报记者 金晶
编辑 胡杰 校对 李立军
新京报报料邮箱:82708677@bjnews.com.cn